Laya-MLX چیست؟ هوش مصنوعی متنبازی که بهجای نوشتن، روی مک در ۷ میلیثانیه تصمیم میگیرد
Laya-MLX پورت متنباز مدل تصمیمگیر Laya برای مکهای اپل سیلیکون است که بدون تولید حتی یک توکن و کاملاً محلی، در حدود ۷ تا ۱۴ میلیثانیه تصمیم میگیرد. در این مطلب معماری، بنچمارکها، محدودیتها و مقایسهی آن با Jev را بررسی میکنیم.
در کمتر از دو هفته، دنیای هوش مصنوعی درگیر ایدهای تازه شده است: مدلهایی که قرار نیست حرف بزنند، فقط قرار است تصمیم بگیرند.
وقتی استارتاپ TypeSafe AI در ۱۵ سپتامبر ۲۰۲۶ مدل تجاری Jev را معرفی کرد، خیلی زود مدل متنباز و رایگانی به نام Laya از شرکت Convai Innovations هم مطرح شد. تنها چند روز بعد، توسعهدهندهای مستقل با نام کاربری mizorewww همین مدل را بهصورت بومی روی چارچوب MLX اپل پیاده کرد و Laya-MLX متولد شد؛ پروژهای که در زمان نگارش این مطلب، در کمتر از یک هفته بیش از ۴ هزار ستاره در گیتهاب گرفته است.
در این مطلب بررسی میکنیم Laya-MLX دقیقاً چیست، چطور کار میکند، اعداد و ارقامش تا چه حد قابل اتکاست، چه محدودیتهایی دارد و در کنار Jev کجا میایستد. همهی اعداد از مستندات رسمی و مخازن اصلی پروژهها گرفته شده و فهرست منابع در انتهای مطلب آمده است.
Laya-MLX در یک نگاه
Laya-MLX یک رانتایم (محیط اجرای) متنباز است که خانوادهی مدلهای تصمیمگیر Laya را مستقیماً روی تراشههای اپل سیلیکون (سری M) و با MLX اجرا میکند؛ MLX چارچوب متنباز یادگیری ماشین اپل است که برای حافظهی یکپارچهی این تراشهها طراحی شده. Laya-MLX چتبات یا مدل تولید متن نیست: ورودی آن یک «وضعیت» (متن، ایمیل، تیکت یا JSON) بههمراه چند سؤال از پیش تعریفشده است و خروجیاش احتمال هر پاسخ مجاز — بدون تولید حتی یک توکن خروجی.
- سرعت: میانهی حدود ۱۳٫۴ میلیثانیه برای یک سؤال کوتاه انگلیسی و حدود ۷٫۴ میلیثانیه با چکپوینت چندزبانه، روی یک مک با تراشهی M3 Max.
- کاملاً محلی: پس از دانلود اولیهی وزنها، برای استنتاج به هیچ API ابری، PyTorch یا کتابخانهی Transformers نیاز ندارد.
- مجوز: Apache-2.0، هم برای کد پورت و هم برای وزنهای اصلی Laya.
- وضعیت: یک پورت مستقل است و انتشار رسمی Convai Innovations یا اپل به حساب نمیآید.
پیشزمینه: چرا ناگهان همه از مدلهای «سیستم یک» حرف میزنند؟
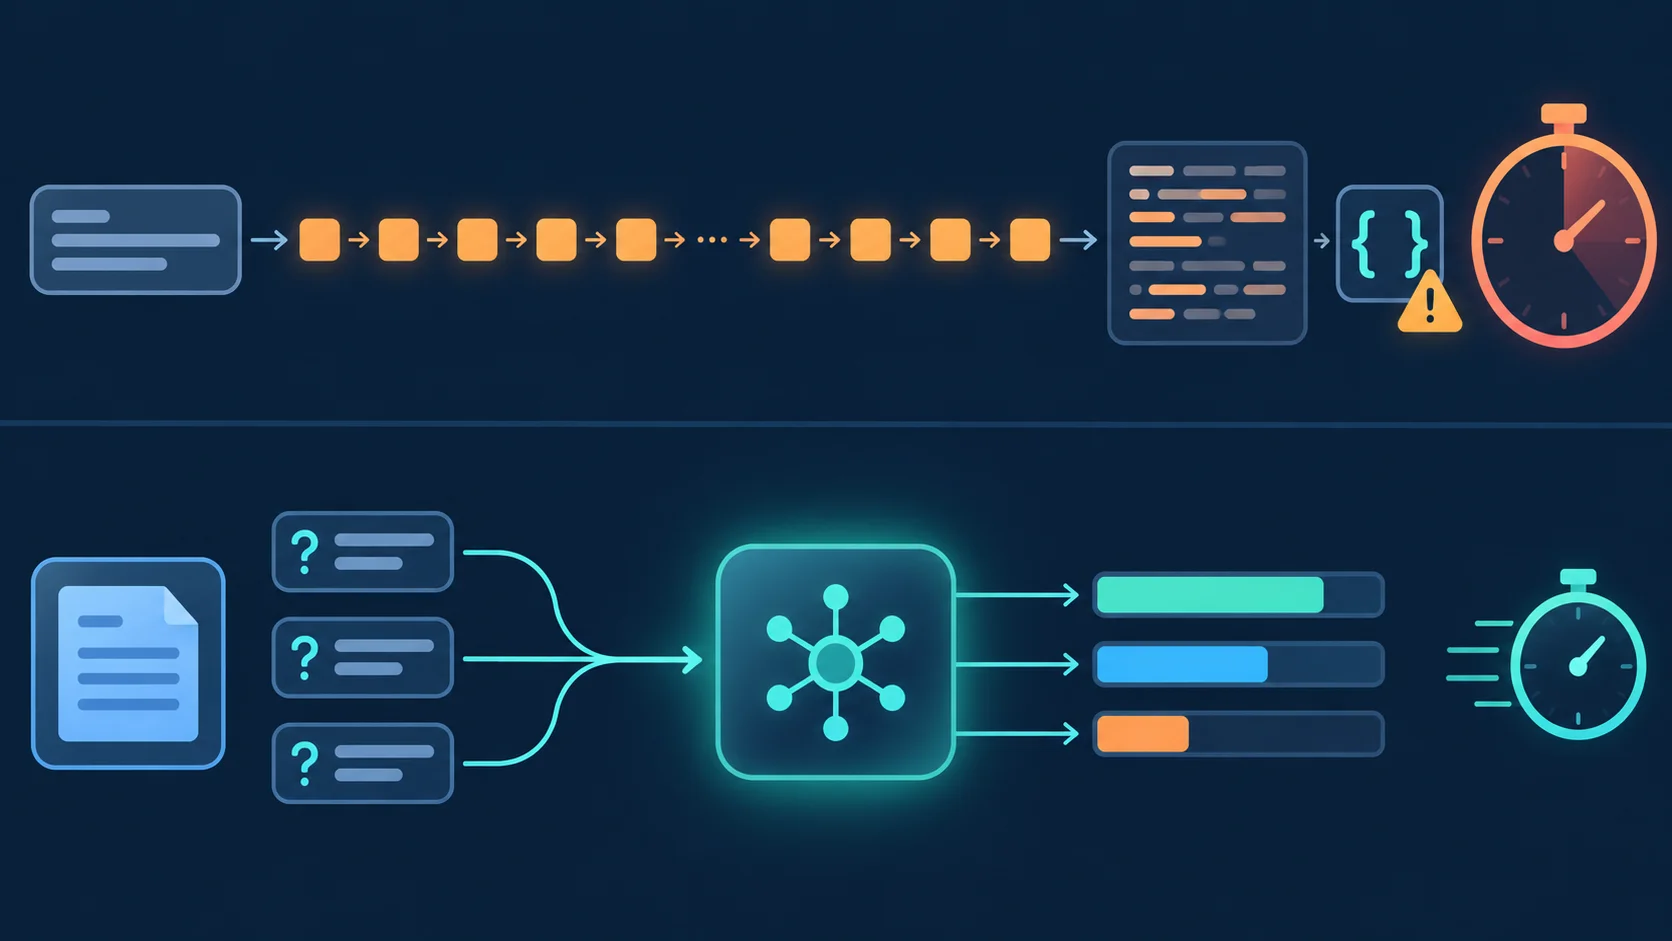
بیشتر مدلهای زبانی امروزی خودبازگشتی (autoregressive) هستند و پاسخ را توکن به توکن میسازند. این روش برای نوشتن ایمیل یا کد عالی است، اما وقتی نرمافزار فقط میخواهد بداند یک تیکت «مالی» است یا «فنی»، تولید یک پاراگراف و بعد تجزیهی آن برای بیرون کشیدن یک برچسب، هم کند است، هم پرهزینه و هم مستعد خطای قالببندی.
TypeSafe AI، استارتاپی به رهبری Diogo Almeida (پژوهشگر سابق OpenAI)، با همین استدلال Jev را معرفی کرد و این دسته را «مدلهای سیستم یک» نامید؛ اشارهای به تفکر سریع و شهودی در نظریهی دانیل کانمن. طبق گزارشها، این شرکت پس از دو سال فعالیت پنهان و با ۴۰ میلیون دلار سرمایهی اولیه به رهبری DCVC رونمایی شد و قیمت Jev را ۰٫۰۴۲ دلار به ازای هر یک میلیون توکن ورودی اعلام کرد. اما Jev یک API بسته است و وزنهایش منتشر نشدهاند.
اینجا بود که Laya وارد میدان شد. Nandakishor Mukkunnoth، بنیانگذار Convai Innovations، مدل Laya را با وزنهای باز منتشر کرد و مدعی شد ایدهی اصلی این رویکرد — مدل غیرخودبازگشتیِ آموزشدیده با یادگیری تقویتی — را حدود یک سال زودتر، در مقالهای در arXiv در مارس ۲۰۲۵، مطرح کرده بود. این ادعای تقدم در جامعهی توسعهدهندگان واکنشهای متفاوتی داشته، اما هرچه باشد، Laya حالا گزینهی باز و قابل اجرا بهصورت محلی در این دسته است و Laya-MLX همین مدل را با سرعت بومی به کاربران مک رسانده است.
Laya چطور کار میکند؟
بهجای پرامپت آزاد، برنامهنویس از قبل سؤالها و شکل پاسخهای مجاز را تعریف میکند. مسیر پردازش ساده است:
- وضعیت (state) و سؤالهای تایپشده به مدل داده میشوند.
- یک انکودر دوطرفه (bidirectional) کل ورودی را یکجا میخواند، نه کلمه به کلمه.
- سرهای تصمیم (decision heads) برای هر گزینه امتیاز محاسبه میکنند.
- خروجی، توزیع احتمال روی پاسخهای مجاز است؛ چیزی برای تجزیه یا اعتبارسنجی قالب وجود ندارد.
سه نوع تصمیم
choice: انتخاب از میان چند گزینهی نامدار؛ مثلاً «این پیام را کدام تیم رسیدگی کند: مالی، فنی یا فروش؟» خروجی: احتمال هر گزینه.score: امتیاز روی یک مقیاس ترتیبی؛ مثلاً میزان فوریت از «عادی» تا «بحرانی». خروجی: احتمال هر سطح و امتیاز مورد انتظار.noul: احتمال درست بودن یک گزاره؛ مثلاً «آیا مشتری درخواست بازپرداخت کرده است؟»
معماری
چکپوینت اصلی انگلیسی روی ModernBERT-large (حدود ۳۹۵ میلیون پارامتر) ساخته شده و یک «سر تصمیم» که از صفر آموزش دیده به آن اضافه شده است: دو لایهی ترنسفورمر، یک امتیازدهندهی گزینهها و یک سر «اقدام/ارجاع» (act/escalate). مجموع پارامترها حدود ۴۲۱ میلیون است. نکتهی جالب این است که هر گزینه در جایگاه توکن [MASK] مخصوص به خودش امتیاز میگیرد؛ یعنی فضای پاسخ هنگام درخواست تعریف میشود و برای سؤالها و گزینههای جدید نیازی به آموزش دوباره نیست.
آموزش با RLCD
Laya با روشی به نام RLCD (یادگیری تقویتی برای تصمیمهای کالیبره) آموزش دیده است. مدل یک توزیع احتمال گزارش میکند و پاداشش با «قواعد امتیازدهی اکیداً سره» (strictly proper scoring rules) سنجیده میشود: ترکیبی از امتیاز لگاریتمی و کروی، و برای سؤالهای ترتیبی، امتیاز احتمال رتبهای. ویژگی این قواعد آن است که بیشترین پاداش مورد انتظار فقط وقتی به دست میآید که مدل احتمالهای صادقانه گزارش کند، نه پاسخهایی با اطمینان کاذب. بهروزرسانیها به سبک REINFORCE با خط پایهی میانگین گروهی (شبیه GRPO) انجام میشود.
توجه داشته باشید که Laya-MLX فقط استنتاج و تبدیل وزن را پوشش میدهد؛ آموزش RLCD و فاینتیون همچنان در مخزن اصلی Laya انجام میشود.
سه چکپوینت پشتیبانیشده
| مدل | انکودر پایه | پارامترها | سقف کانتکست (توکن) | کاربرد |
|---|---|---|---|---|
| laya | ModernBERT-large | ۴۲۱ میلیون | ۵۱۲ | متن انگلیسی |
| laya-multilingual | mmBERT-base | ۳۲۲ میلیون | ۱٬۰۲۴ | ورودی چندزبانه (بیش از ۱۰۰ زبان) |
| laya-typed-decisions | ModernBERT-large | ۴۲۱ میلیون | ۱٬۰۲۴ | گردشکارهای تخصصی typed-decisions |
نسخههای FP16 از پیش تبدیلشدهی هر سه مدل در Hugging Face منتشر شدهاند. طبق مستندات، تبدیل فقط نام پارامترها و نوع داده را برای MLX تغییر میدهد؛ نه آموزش دوبارهای در کار است و نه کوانتیزهسازی به بیتهای کمتر. سقف کانتکست شامل دستورالعملها، گزینهها و خود وضعیت است.
برای متن فارسی: چکپوینت انگلیسی روی خطهای غیرلاتین عملکرد بسیار ضعیفی دارد (جزئیات در بخش محدودیتها)؛ برای ورودی فارسی باید از laya-multilingual استفاده کنید.
عملکرد روی M3 Max: اعداد دقیق
سازندهی Laya-MLX آزمونها را روی یک مک با تراشهی M3 Max (پردازندهی گرافیکی ۴۰ هستهای و ۱۲۸ گیگابایت حافظهی یکپارچه) انجام داده است. زمانها «سرتاسری» (end-to-end) هستند؛ یعنی آمادهسازی پرامپت، توکنسازی، اجرای مدل، کالیبراسیون و قالببندی نتیجه را شامل میشوند، اما زمان بارگذاری مدل را نه.
| معیار (FP16) | Laya (۴۲۱M) | Multilingual (۳۲۲M) |
|---|---|---|
| یک سؤال کوتاه، میانه (P50) | ۱۳٫۴۲ میلیثانیه | ۷٫۳۹ میلیثانیه |
| یک سؤال کوتاه، صدک ۹۵ (P95) | ۱۳٫۹۲ میلیثانیه | ۷٫۷۹ میلیثانیه |
| توان عملیاتی با ۵۰ سؤال | ۱۴۶٫۸ سؤال در ثانیه | ۳۹۵ سؤال در ثانیه |
| اوج حافظهی MLX برای یک سؤال | ۹۴۳٫۶ مبیبایت | ۶۸۷٫۶ مبیبایت |
مقایسه با رانتایم اصلی روی همان مک
مقایسهی منصفانهتر، اجرای همان مدل با رانتایم اصلی (PyTorch روی MPS) روی همان دستگاه است. میانهی زمان برای یک سؤال کوتاه (میلیثانیه):
| چکپوینت | PyTorch MPS FP32 | MLX FP32 | MLX FP16 |
|---|---|---|---|
| laya | ۲۴٫۹۲ | ۱۵٫۹۵ | ۱۳٫۴۲ |
| laya-multilingual | ۱۹٫۳۵ | ۷٫۹۹ | ۷٫۳۹ |
| laya-typed-decisions | ۲۴٫۸۰ | ۱۵٫۸۶ | ۱۳٫۷۱ |
برای یک سؤال، MLX FP16 تقریباً ۱٫۹ برابر (مدل انگلیسی) تا ۲٫۶ برابر (مدل چندزبانه) سریعتر از رانتایم اصلی است و حتی با دقت یکسان FP32 هم حدود ۱٫۶ تا ۲٫۴ برابر جلوتر است. با بیشتر شدن تعداد سؤالها این فاصله کم میشود؛ مثلاً برای ۱۰ سؤال روی مدل انگلیسی، MLX FP32 کمی کندتر از PyTorch بود و مزیت اصلی از FP16 میآمد. با ورودی بلندی که کل کانتکست را پر کند هم زمانها بالا میرود: یک سؤال با کانتکست کامل روی مدل انگلیسی حدود ۴۵ میلیثانیه و روی مدل typed-decisions (با کانتکست ۱٬۰۲۴ توکنی) حدود ۹۹ میلیثانیه طول کشید.
سازنده صریحاً تأکید میکند که اینها اندازهگیری یک دستگاه در یک اجراست و ادعایی دربارهی سختافزارهای دیگر ندارد؛ پس روی تراشههای پایهی M1 یا M2 اعداد متفاوتی انتظار داشته باشید. جالب اینکه گزارش پژوهشی خود پروژه هم میگوید با همین چکپوینتها شواهدی برای ۱۰ برابر سریعتر شدنِ همگانی پیدا نکرده و بهینهسازیهای بیشتر در موارد منتخب فقط حدود ۳ تا ۸ درصد بهبود دادهاند؛ صداقتی که در پروژههای پرسروصدا کمتر میبینیم.
یکی از نقاط قوت Laya-MLX، مستندسازی دقیق «وفاداری» به مدل اصلی است:
- هر سه چکپوینت، در هر دو دقت FP32 و FP16، روی ۶۳ سؤال اعتبارسنجی (۱۶ سناریو شامل هشت زبان، وضعیت خالی و طولانی، مکالمهها و سؤالهای ۲۰ گزینهای) دقیقاً همان گزینهای را انتخاب کردند که نسخهی اصلی انتخاب کرده بود؛ یعنی ۳۷۸ مقایسه از ۳۷۸ مقایسه.
- بیشترین اختلاف احتمال کالیبرهشده در FP16 حدود ۰٫۰۰۵ و در FP32 در حد چند میلیونیم بود.
- ۱۰۰ فراخوانی تکراری خروجی کاملاً یکسان و قطعی داد و رشد حافظهی فعال صفر بایت اندازهگیری شد.
- روی نمونهی ۲۵۶تایی از دادهی AG News، دقت نسخهی MLX دقیقاً برابر PyTorch بود (برای مثال ۹۵٫۷ درصد در مدل انگلیسی) و هر ۲۵۶ پیشبینی با هم مطابقت داشت.
البته این آزمونها وفاداری پورت به مدل اصلی را میسنجند، نه درستی مدل در هر سؤال دلخواه.
دموی Snake: هوش مصنوعیای که برای هر حرکت تصمیم میگیرد
معروفترین بخش پروژه، دموی بازی مار (Snake) در ترمینال است. در این دمو برای هر حرکت مار، Laya فراخوانی میشود تا جهت بعدی را انتخاب کند و یک لایهی ایمنی قابل مشاهده میتواند پیشنهادهای خطرناک را اصلاح کند. در آزمون روی M3 Max با فعال بودن کامپایل و استفادهی مجدد از پیشوند پرامپت، مار ۲٬۴۰۰ حرکت را با سرعت حدود ۷۵ حرکت در ثانیه انجام داد؛ بدون حتی یک بار مردن و فقط با دو بار دخالت لایهی ایمنی.
دقت کنید که این نرخ با عدد ۱۳٫۴ میلیثانیهی بالا مستقیماً قابل مقایسه نیست؛ حلقهی بازی در هر حرکت سه سؤال میپرسد و مسیر بهینهسازی خودش را دارد.
جامعهی توسعهدهندگان هم سریع دستبهکار شده است؛ برای نمونه پروژهی laya-vs-jev دو مدل Laya (محلی با MLX) و Jev (از طریق API میزبانیشده) را کنار هم در بازی دایناسور کروم به رقابت میگذارد تا زمان پاسخ و تصمیمهایشان را همزمان ببینید.
شروع کار با Laya-MLX
پیشنیازها: مک با تراشهی اپل سیلیکون، macOS 14 یا جدیدتر و Python 3.11 یا جدیدتر. نصب:
pip install laya-mlxیک مثال ساده با چکپوینت چندزبانه که برای متن فارسی انتخاب درست است:
import laya_mlx as laya
agent = laya.load("aac6fef/laya-multilingual-mlx")
result = agent.predict(
"سفارشم سه روز است نرسیده و کسی هم جواب تلفن را نمیدهد.",
{
"team": {
"type": "choice",
"instructions": "Which team should handle this message?",
"criteria": ["shipping", "billing", "technical"],
},
"urgency": {
"type": "score",
"instructions": "How urgent is this message?",
"criteria": ["low", "medium", "high"],
},
"frustrated": {
"type": "noul",
"instructions": "Is the customer frustrated?",
},
},
)
print(result["answers"])اولین اجرا وزنها را از Hugging Face دانلود میکند و از آن به بعد استنتاج کاملاً محلی است. برای اجرای دموی Snake:
pip install 'laya-mlx[demo]'
hf download aac6fef/laya-multilingual-mlx
laya-snake
چند قابلیت کاربردی دیگر
- Router: زبان و خط ورودی را تشخیص میدهد و چکپوینت مناسب را خودکار انتخاب میکند؛ مثلاً متنهای غیرلاتین را به مدل چندزبانه میفرستد.
- حالت بهینه برای بار تکراری: گزینههای
compile=True،pad_to_multiple=16وcache_prompts=Trueهنگام بارگذاری مدل (هر سه بهطور پیشفرض خاموشاند). - predict_shortlist: برای سؤالهایی با صدها گزینه، ابتدا با شباهت کسینوسی نزدیکترین گزینهها را جدا میکند و تصمیم نهایی را روی همانها میگیرد.
- خط فرمان: دستورهای
laya-mlx predictوlaya-mlx convertبرای پیشبینی و تبدیل چکپوینتها.
Laya-MLX در برابر Jev
| ویژگی | Laya-MLX (اجرای محلی Laya) | Jev (TypeSafe AI) |
|---|---|---|
| نوع دسترسی | اجرا روی مک خودتان | API ابری میزبانیشده |
| وزنها | باز، Apache 2.0 | بسته |
| هزینه | رایگان (فقط سختافزار خودتان) | ۰٫۰۴۲ دلار به ازای هر میلیون توکن ورودی؛ خروجی رایگان |
| تأخیر یک سؤال | حدود ۷ تا ۱۴ میلیثانیه روی M3 Max | ۷۰ تا ۵۰۰ میلیثانیه طبق اعلام سازنده؛ میانهی ۲۳۶ تا ۲۷۶ میلیثانیه در سنجشهای مستقل |
| حریم خصوصی | داده از دستگاه خارج نمیشود | داده به سرور ارسال میشود |
| تعداد زیاد گزینه | ضعیف در تنظیمات پیشفرض (بالای حدود ۲۰ گزینه) | قویتر؛ پشتیبانی تا ۲۵۵ گزینه |
چند نکته برای مقایسهی منصفانه:
- اعداد Laya-MLX بدون رفتوبرگشت شبکه و روی یک مک قدرتمند اندازهگیری شدهاند، در حالی که زمان Jev شامل تأخیر شبکه است؛ پس این دو عدد دقیقاً همسنگ نیستند.
- روی بنچمارک typed-decisions، چکپوینت فاینتیونشدهی Laya دقت ۰٫۷۶۶ گرفته، در برابر عدد ۰٫۷۲۷ که برای Jev 1.13.0 منتشر شده است. اما Convai خودش تأکید میکند که اعداد Jev را شخصاً اندازه نگرفته و نمونهها و پرامپتها متفاوتاند؛ پس این مقایسه تقریبی است.
- Jev در برخی زمینهها جلوتر است: روی مجموعهدادهی Banking77 با بیش از ۷۰ برچسب، Jev به دقت ۰٫۸۷۰ رسیده و Laya به ۰٫۴۲۵. در «دقت نرم» (تطابق با کل توزیع احتمال مرجع) هم Jev بهتر عمل کرده است.
محدودیتها و نکاتی که باید بدانید
- ضعف در حالت zero-shot: روی بنچمارک typed-decisions، چکپوینت پایهی انگلیسی بدون فاینتیون فقط ۰٫۳۶۲ گرفته (نسخهی چندزبانه هم در همین حدود)؛ کمی بالاتر از حدس تصادفی (۰٫۳۱۸) و حتی پایینتر از انتخاب همیشگی رایجترین پاسخ (۰٫۴۶۱). عدد ۰٫۷۶۶ متعلق به نسخهای است که روی دادهی آموزشی همان بنچمارک فاینتیون شده. به تعبیر خود Convai، Laya پایهای سریع برای تخصصیسازی است، نه یک موتور تصمیم آماده برای هر وظیفه.
- اطمینان بیش از حد: مدلها در حالت پیشفرض بیش از اندازه مطمئناند. طبق گزارش Convai، تنظیم دوبارهی دما برای هر نوع سؤال و تعداد گزینه، خطای کالیبراسیون (ECE) مدل انگلیسی را از ۰٫۴۶۶ به ۰٫۰۸۱ میرساند؛ پس پیش از اعتماد به احتمالها، کالیبراسیون را روی دادهی خودتان انجام دهید. Laya-MLX هم به پیروی از نسخهی اصلی، دماهای کالیبراسیون را به بازهی ۰٫۵ تا ۵ محدود میکند تا یک حالت پنجاهپنجاه بهاشتباه «تقریباً قطعی» گزارش نشود.
- مدل انگلیسی و خطهای غیرلاتین: چکپوینت انگلیسی روی خطهای غیرلاتین فرو میریزد؛ Convai گزارش کرده که روی زبان خمر دقت صفر با اطمینان ۰٫۹۵۲ داشته است. یعنی مدل در عین اشتباه کامل، کاملاً مطمئن است و آستانهگذاری روی اطمینان هم نجاتتان نمیدهد. برای فارسی حتماً از مدل چندزبانه یا Router استفاده کنید.
- گزینههای زیاد: همهی گزینهها یک بودجهی توکن مشترک دارند؛ با دهها گزینه، سهم هر برچسب فقط چند توکن میشود و دقت افت میکند. توصیه این است که گزینهها زیر حدود ۲۰ بمانند یا تصمیم به دو مرحلهی کلی و جزئی تقسیم شود.
- سؤالهای امتیازی: نوع
scoreضعیفترین نوع تصمیم در Laya است. - پوشش سختافزاری محدود: همهی بنچمارکها روی یک M3 Max انجام شده و نسخههای قدیمیتر macOS روی آن دستگاه آزموده نشدهاند.
- بدون آموزش: Laya-MLX فقط استنتاج دارد؛ در زمان نگارش، یکی از اولین درخواستهای کاربران در گیتهاب، اضافه شدن آموزش مستقیم با MLX بوده است.
- غیررسمی بودن: پروژه یک پورت مستقل است و پشتیبانی رسمی Convai یا اپل را ندارد.
Laya-MLX به چه کاری میآید؟
Laya-MLX جایگزین مدلهای زبانی بزرگ نیست؛ بهترین جایگاهش «لایهی تصمیم» در کنار آنهاست. Convai Innovations کاربردهای هدف Laya را پردازش فاکتور، مسیریابی تیکت، نظارت بر محتوا، گاردریلها و پایش رفتار ایجنتها معرفی میکند. چند سناریوی ملموس:
- دستهبندی و اولویتبندی ایمیل و تیکت پشتیبانی، پیش از آنکه یک مدل زبانی پاسخ را بنویسد.
- گاردریل سریع: بررسی ناامن بودن یک ورودی یا خروجی در چند میلیثانیه.
- ایجنتها و بازیها: انتخاب اقدام بعدی از میان مجموعهای محدود، مثل دموی Snake.
- اپلیکیشنهای حساس به حریم خصوصی که دادهی کاربر نباید از دستگاه خارج شود.
پروژهی همخانواده: Laya-CoreML
همان توسعهدهنده نسخهی دیگری به نام laya-coreml هم منتشر کرده که مدل را روی Core ML و موتور عصبی (Neural Engine) اپل اجرا میکند. طبق گزارش پروژه، تصمیمهای کوتاه روی موتور عصبی M3 Max با میانهی حدود ۴٫۹۸ میلیثانیه انجام میشوند و انرژی مصرفی هر تصمیم ۲٫۷۸ تا ۳٫۱۹ برابر بهتر از نسخهی کامپایلشدهی MLX FP16 است. البته بستهی مخصوص موتور عصبی سقف کلی ۹۶ توکن (شامل سؤال، گزینهها و وضعیت) دارد و برای ورودیهای بلندتر باید سراغ مدل عمومی ۱٬۰۲۴ توکنی همان پروژه یا نسخهی MLX رفت.
پرسشهای متداول
تفاوت Laya و Laya-MLX چیست؟
Laya خانوادهی مدلهای تصمیمگیر ساخت Convai Innovations است که بهطور رسمی با PyTorch اجرا میشود. Laya-MLX یک رانتایم مستقل است که همان وزنها را بدون تغییر، بهصورت بومی روی MLX و تراشههای اپل اجرا میکند.
آیا Laya-MLX یک چتبات است؟
نه. هیچ متنی تولید نمیکند و فقط به سؤالهایی که از قبل تعریف کردهاید، با احتمال پاسخ میدهد.
روی مکهای M1 و M2 هم کار میکند؟
پیشنیاز رسمی، تراشهی اپل سیلیکون و macOS 14 به بعد است؛ اما بنچمارکهای منتشرشده فقط مربوط به M3 Max هستند و روی تراشههای دیگر اعداد متفاوت خواهد بود.
آیا از زبان فارسی پشتیبانی میکند؟
چکپوینت چندزبانه برای بیش از ۱۰۰ زبان طراحی شده و انتخاب درست برای متن غیرانگلیسی است، اما در منابعی که بررسی کردیم عدد مشخصی برای دقت فارسی منتشر نشده بود؛ پیش از استفادهی جدی، آن را روی دادهی خودتان ارزیابی کنید.
آیا استفاده از آن رایگان است؟
بله. هم کد Laya-MLX و هم وزنهای Laya با مجوز Apache-2.0 منتشر شدهاند و استفادهی تجاری هم مجاز است.
جمعبندی
Laya-MLX نمونهی خوبی از سرعت اکوسیستم متنباز است: کمتر از یک هفته پس از داغ شدن بحث مدلهای «سیستم یک»، حالا هر کسی با یک مک اپل سیلیکون میتواند یک مدل تصمیمگیر کالیبره را کاملاً محلی، رایگان و در حد چند میلیثانیه اجرا کند. مستندسازی شفاف پروژه — از روش بنچمارک تا آزمونهای وفاداری — آن را از بسیاری از پروژههای پرسروصدای مشابه متمایز میکند.
اما واقعبین باشید: Laya بدون فاینتیون روی وظایف پیچیده چندان قوی نیست، احتمالهایش نیاز به کالیبراسیون دارند و برای فارسی باید حتماً از نسخهی چندزبانه استفاده کرد. اگر وظیفهای مشخص و تکرارشونده دارید — مثل مسیریابی تیکت یا گاردریل — و دادهی کافی برای ارزیابی (و ترجیحاً فاینتیون) در اختیارتان است، Laya-MLX قطعاً ارزش آزمودن را دارد.
منابع مرتبط
- مخزن رسمی Laya-MLX در گیتهاب
- گزارش کامل بنچمارکهای Laya-MLX (BENCHMARKS.md)
- وزنهای FP16 تبدیلشده برای MLX در Hugging Face
- بستهی laya-mlx در PyPI
- کارت مدل رسمی Laya از Convai Innovations در Hugging Face
- مخزن اصلی Laya در گیتهاب
- وبسایت و یادداشت رسمی Laya از بنیانگذار Convai Innovations
- پروژهی Laya-CoreML برای موتور عصبی اپل
- پروژهی laya-vs-jev: رقابت همزمان Laya و Jev در بازی دایناسور کروم
- The Rundown AI: معرفی Jev از TypeSafe
- MLX، چارچوب یادگیری ماشین اپل
توسعهدهنده فولاستک