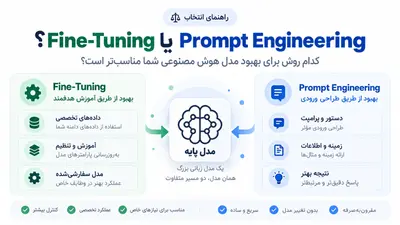
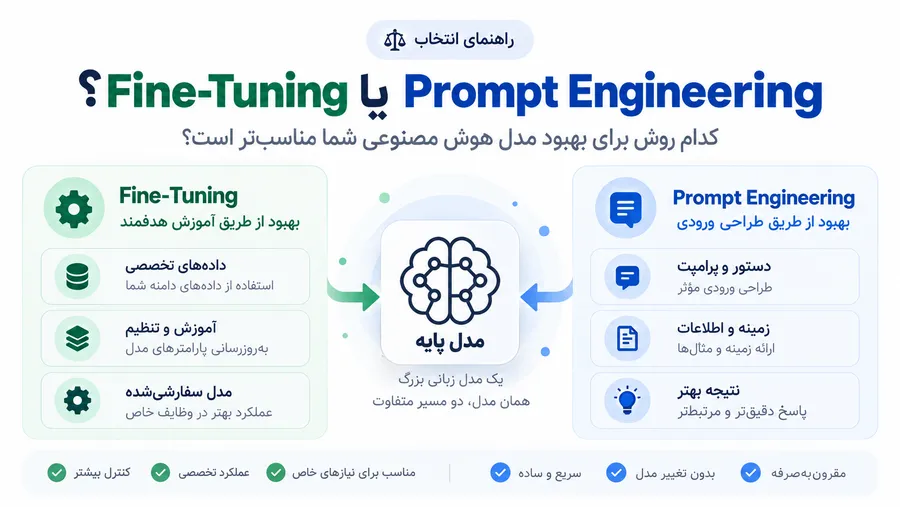
Prompt Engineering یا Fine-Tuning؟ مقایسه کامل و راهنمای انتخاب
Prompt Engineering و Fine-Tuning دو روش مهم برای بهبود عملکرد مدلهای زبانی هستند، اما مسئلههای متفاوتی را حل میکنند. در این راهنما تفاوتها، هزینهها، کاربردها، LoRA، RAG و یک چارچوب عملی برای انتخاب روش مناسب را بررسی میکنیم.
وقتی یک مدل زبانی بزرگ پاسخ دقیقی نمیدهد، معمولاً اولین سؤال این است: «باید پرامپت را بهتر کنیم یا مدل را Fine-Tune کنیم؟» پاسخ کوتاه این است که این دو روش رقیب مطلق هم نیستند.
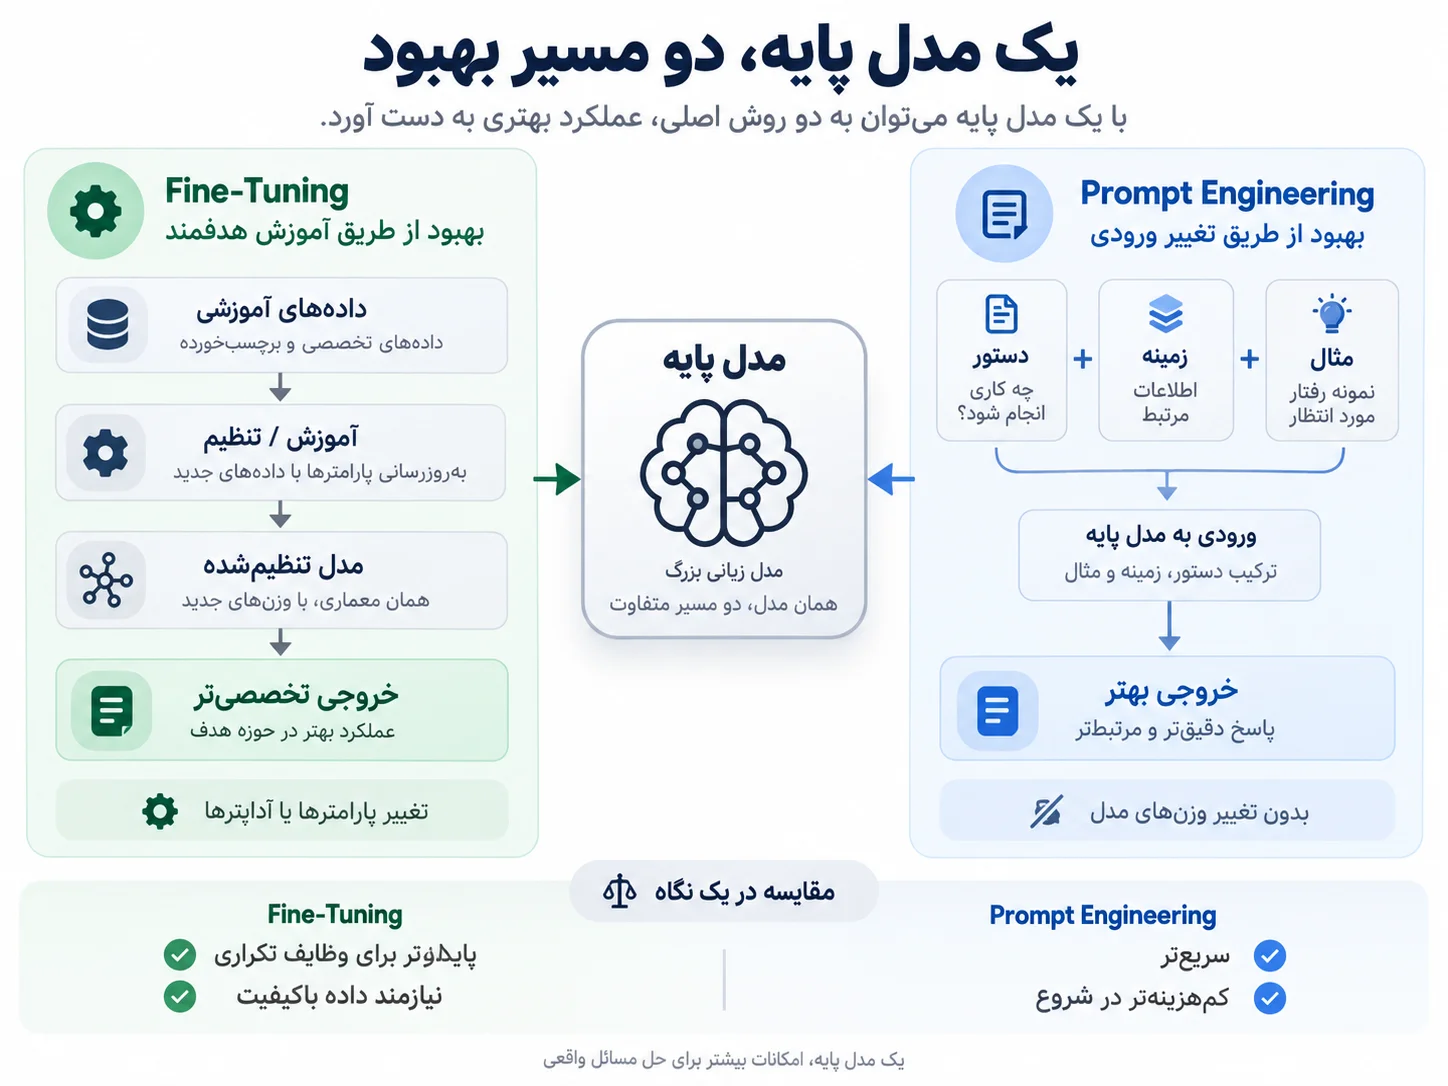
Prompt Engineering رفتار مدل را در زمان اجرا و از طریق دستور، زمینه و مثال هدایت میکند؛ Fine-Tuning با آموزش روی دادههای هدفمند، رفتار مدل را در سطح پارامترها یا آداپترهای قابلآموزش تغییر میدهد.
انتخاب درست به نوع مسئله، حجم استفاده، کیفیت داده، هزینه، نیاز به ثبات خروجی و سرعت تغییر محصول بستگی دارد.
در این راهنما تفاوت Prompt Engineering و Fine-Tuning را از دید عملی بررسی میکنیم؛ نه فقط اینکه هرکدام چیست، بلکه اینکه در چه شرایطی یکی از دیگری منطقیتر است، چه زمانی باید هر دو را ترکیب کرد و چرا برای بعضی مسائل اصلاً باید سراغ RAG رفت.
Prompt Engineering چیست؟
Prompt Engineering یا مهندسی پرامپت، فرایند طراحی و بهینهسازی ورودی مدل برای رسیدن به خروجی بهتر است. در این روش پارامترهای مدل تغییر نمیکنند. شما تلاش میکنید با دستور دقیق، زمینه کافی، مثال، محدودیت و قالب خروجی، تواناییهایی را که مدل از قبل دارد به شکل قابلاعتمادتر فعال کنید.
یک پرامپت خوب معمولاً مشخص میکند مدل چه نقشی دارد، دقیقاً چه کاری باید انجام دهد، ورودی چیست، خروجی باید چه ساختاری داشته باشد و چه معیارهایی باید رعایت شود. گاهی یک دستور ساده کافی است و گاهی چند مثال ورودی/خروجی به پرامپت اضافه میشود که به آن few-shot prompting میگویند.
مثال ساده از Prompt Engineering
فرض کنید میخواهیم پیام مشتری را در یکی از سه دسته «فنی»، «مالی» و «عمومی» قرار دهیم. بهجای اینکه فقط بگوییم «این پیام را دستهبندی کن»، میتوانیم دستهها را تعریف کنیم، چند نمونه بدهیم و خروجی را محدود کنیم تا فقط یک مقدار مشخص برگردد. بدون هیچ آموزش مجددی، همین تغییر میتواند کیفیت و ثبات پاسخ را به شکل محسوسی افزایش دهد.
مزیت اصلی Prompt Engineering
بزرگترین مزیت آن سرعت آزمایش است. تغییر یک پرامپت معمولاً بسیار سریعتر از آمادهسازی دیتاست و اجرای فرایند آموزش است. به همین دلیل در بیشتر پروژهها منطقی است ابتدا یک baseline با مدل مناسب و پرامپت خوب ساخته شود، سپس خروجی روی مجموعهای از نمونههای واقعی ارزیابی شود.
Fine-Tuning چیست؟
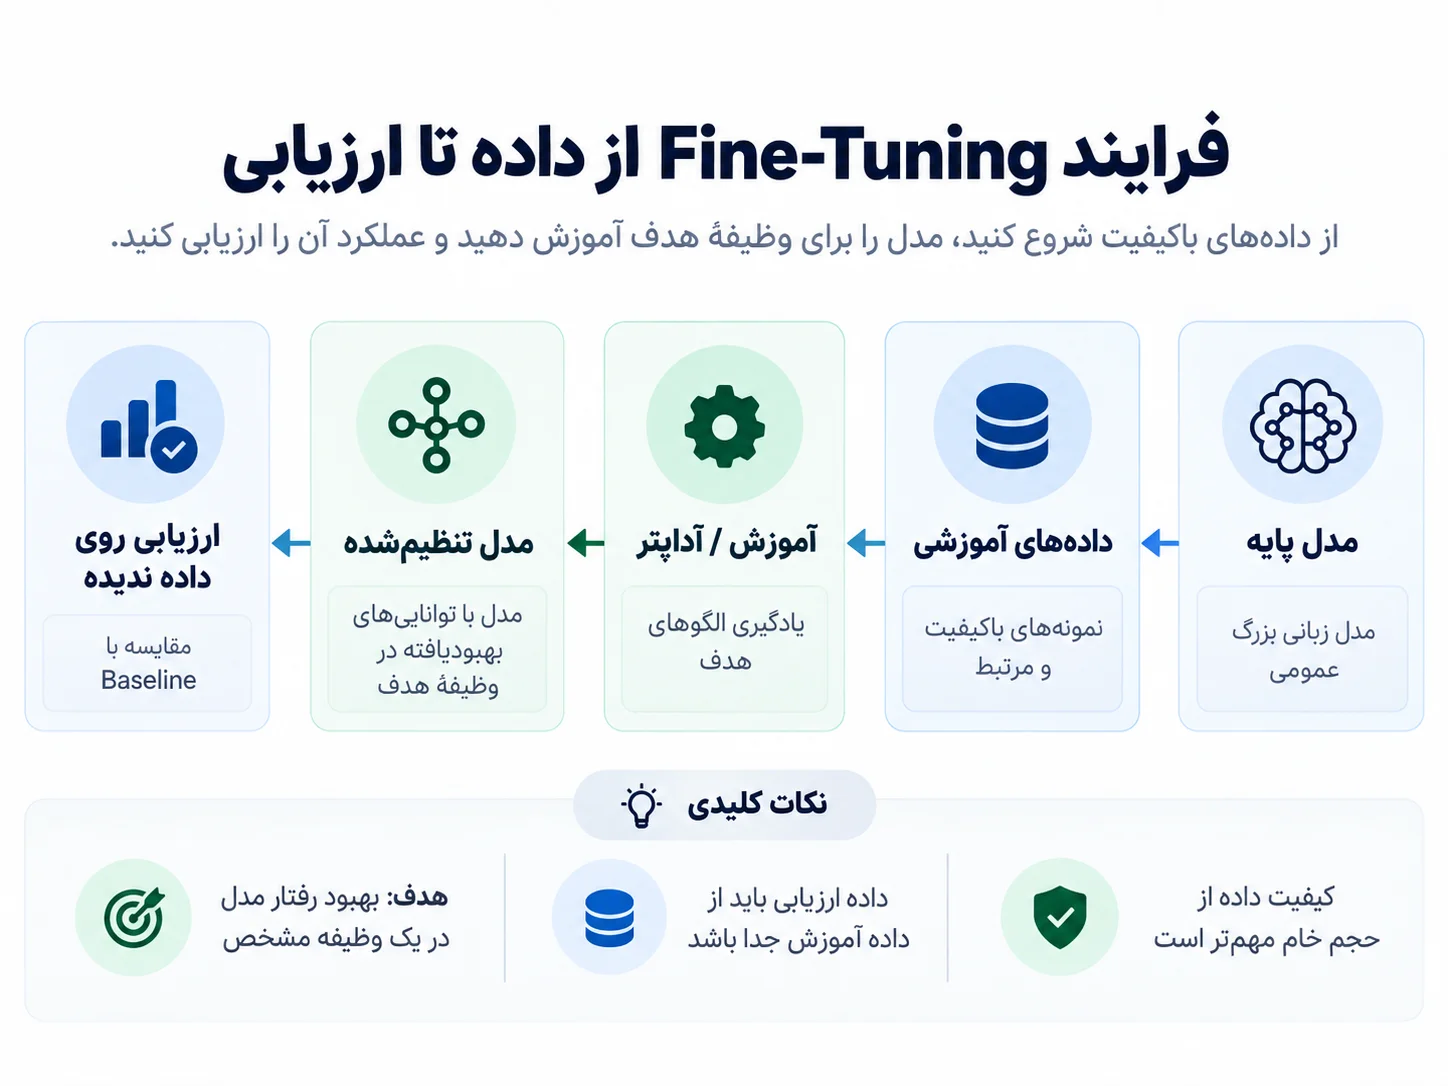
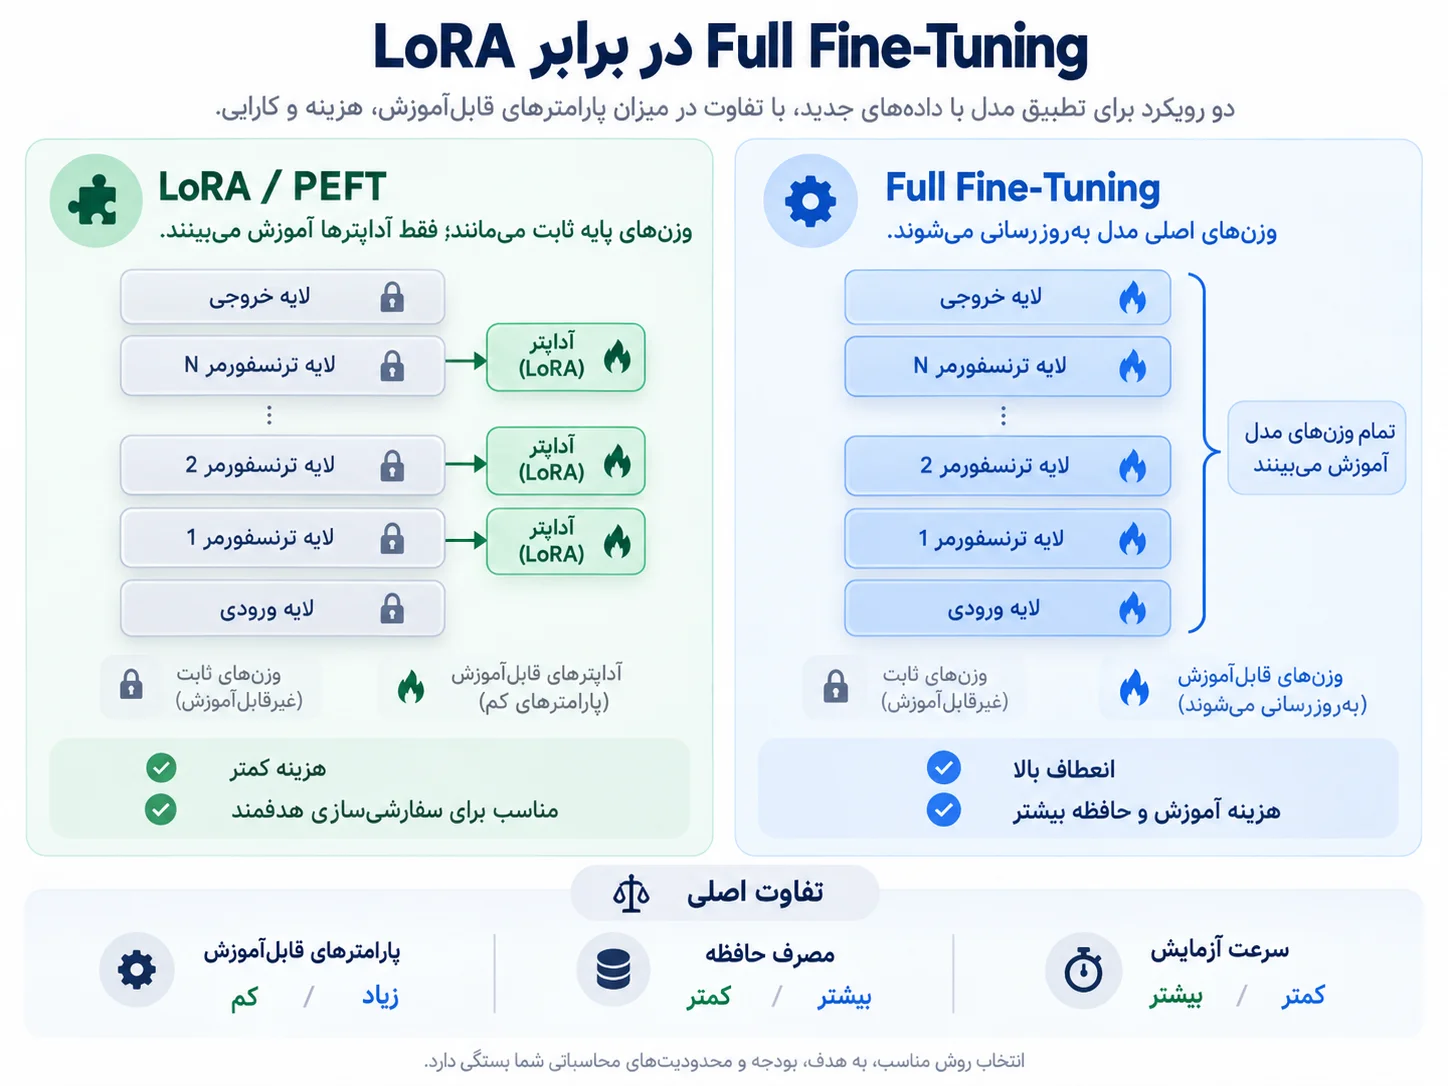
Fine-Tuning یا ریزتنظیم، ادامه آموزش یک مدل از پیشآموزشدیده روی دادههای مرتبط با یک وظیفه یا رفتار مشخص است. هدف این است که مدل الگوهای موردنیاز پروژه را از مجموعهای از مثالهای باکیفیت یاد بگیرد. در Fine-Tuning کامل، وزنهای زیادی از مدل بهروزرسانی میشوند؛ در روشهای Parameter-Efficient Fine-Tuning یا PEFT فقط بخش کوچکی از پارامترها یا آداپترهای اضافهشده آموزش میبینند.
Fine-Tuning زمانی ارزشمند میشود که رفتار مطلوب را بتوان با مثالهای خوب و تکرارشونده نشان داد. برای مثال اگر هزاران نمونه واقعی از تبدیل درخواست کاربر به یک ساختار استاندارد، طبقهبندی تخصصی، لحن برند یا پاسخهای مورد تأیید کارشناسان داشته باشیم، مدل میتواند این الگوها را بهصورت پایدارتر یاد بگیرد.
تفاوت Prompt Engineering و Fine-Tuning در یک نگاه
| معیار | Prompt Engineering | Fine-Tuning |
|---|---|---|
| محل تغییر | ورودی و زمینه در زمان اجرا | وزنها یا پارامترهای/آداپترهای قابلآموزش |
| نیاز به دیتاست آموزشی | الزامی نیست؛ چند مثال میتواند کافی باشد | بله؛ کیفیت داده بسیار مهم است |
| هزینه اولیه | کم | بیشتر، بهدلیل آمادهسازی داده، آموزش و ارزیابی |
| سرعت تغییر | بسیار بالا | کمتر؛ تغییر رفتار ممکن است نیازمند آموزش مجدد باشد |
| ثبات رفتار | به مدل، پرامپت و ورودی وابسته است | برای الگوهای تکرارشونده میتواند پایدارتر باشد |
| طول پرامپت | ممکن است با مثالها و قوانین طولانی شود | میتواند نیاز به تکرار مثالهای زیاد در هر درخواست را کاهش دهد |
| کنترل دانش تازه | با قراردادن context یا اتصال به RAG ممکن است | برای اطلاعات دائماً در حال تغییر راهحل اصلی نیست |
| ریسک اصلی | پرامپت شکننده، طولانی یا وابسته به مدل | داده ضعیف، overfitting، هزینه آموزش و نگهداری |
| مناسب برای شروع پروژه | معمولاً بله | معمولاً پس از ساخت baseline و ارزیابی |
آیا Fine-Tuning از Prompt Engineering بهتر است؟
نه بهصورت مطلق. Fine-Tuning ابزار قدرتمندتری به معنای «بهتر برای همه مسائل» نیست. اگر مدل با یک پرامپت کوتاه و پایدار به کیفیت مطلوب میرسد، آموزش مدل فقط پیچیدگی اضافه میکند. از طرف دیگر، اگر برای هر درخواست مجبور باشید چندین مثال و مجموعه بزرگی از قوانین را ارسال کنید و با وجود آن هنوز خطاهای تکرارشونده داشته باشید، Fine-Tuning میتواند گزینه جدیتری شود.
مقایسه درست باید بر اساس معیار قابلاندازهگیری انجام شود: دقت یا نرخ موفقیت، ثبات قالب، هزینه هر درخواست، latency، طول ورودی، نرخ خطا روی edge caseها و هزینه نگهداری. بدون مجموعه ارزیابی ثابت، ممکن است یک روش «به نظر بهتر» برسد اما در داده واقعی ضعیفتر عمل کند.
چه زمانی Prompt Engineering انتخاب بهتری است؟
- هنوز در مرحله آزمایش و پیدا کردن رفتار درست محصول هستید.
- داده آموزشی باکیفیت و نماینده رفتار واقعی ندارید.
- وظیفه مرتب تغییر میکند و باید بتوانید قوانین را سریع ویرایش کنید.
- مدل با zero-shot یا few-shot prompting به کیفیت قابل قبول میرسد.
- نیاز دارید اطلاعات تازه یا context هر کاربر را در همان درخواست وارد کنید.
- میخواهید قبل از سرمایهگذاری روی آموزش، baseline قابلاندازهگیری بسازید.
در این مرحله بهتر است بهجای اضافهکردن بیپایان متن به پرامپت، ساختار آن را روشن نگه دارید: دستور اصلی، context، مثالها، محدودیتها و قالب خروجی. سپس روی یک مجموعه تست ثابت نسخههای مختلف پرامپت را مقایسه کنید.
چه زمانی Fine-Tuning ارزش بررسی دارد؟
- یک وظیفه مشخص در مقیاس بالا بارها تکرار میشود.
- تعداد کافی نمونه ورودی/خروجی باکیفیت از رفتار مطلوب دارید.
- مدل باید یک سبک، لحن یا فرمت خاص را با ثبات بیشتری رعایت کند.
- پرامپت به مجموعه بزرگی از مثالهای few-shot وابسته شده است.
- خطاهای مشخص و تکرارشوندهای دارید که با اصلاح پرامپت برطرف نشدهاند.
- میخواهید بررسی کنید آیا یک مدل کوچکترِ تنظیمشده میتواند وظیفه تخصصی را با هزینه عملیاتی مناسب انجام دهد.
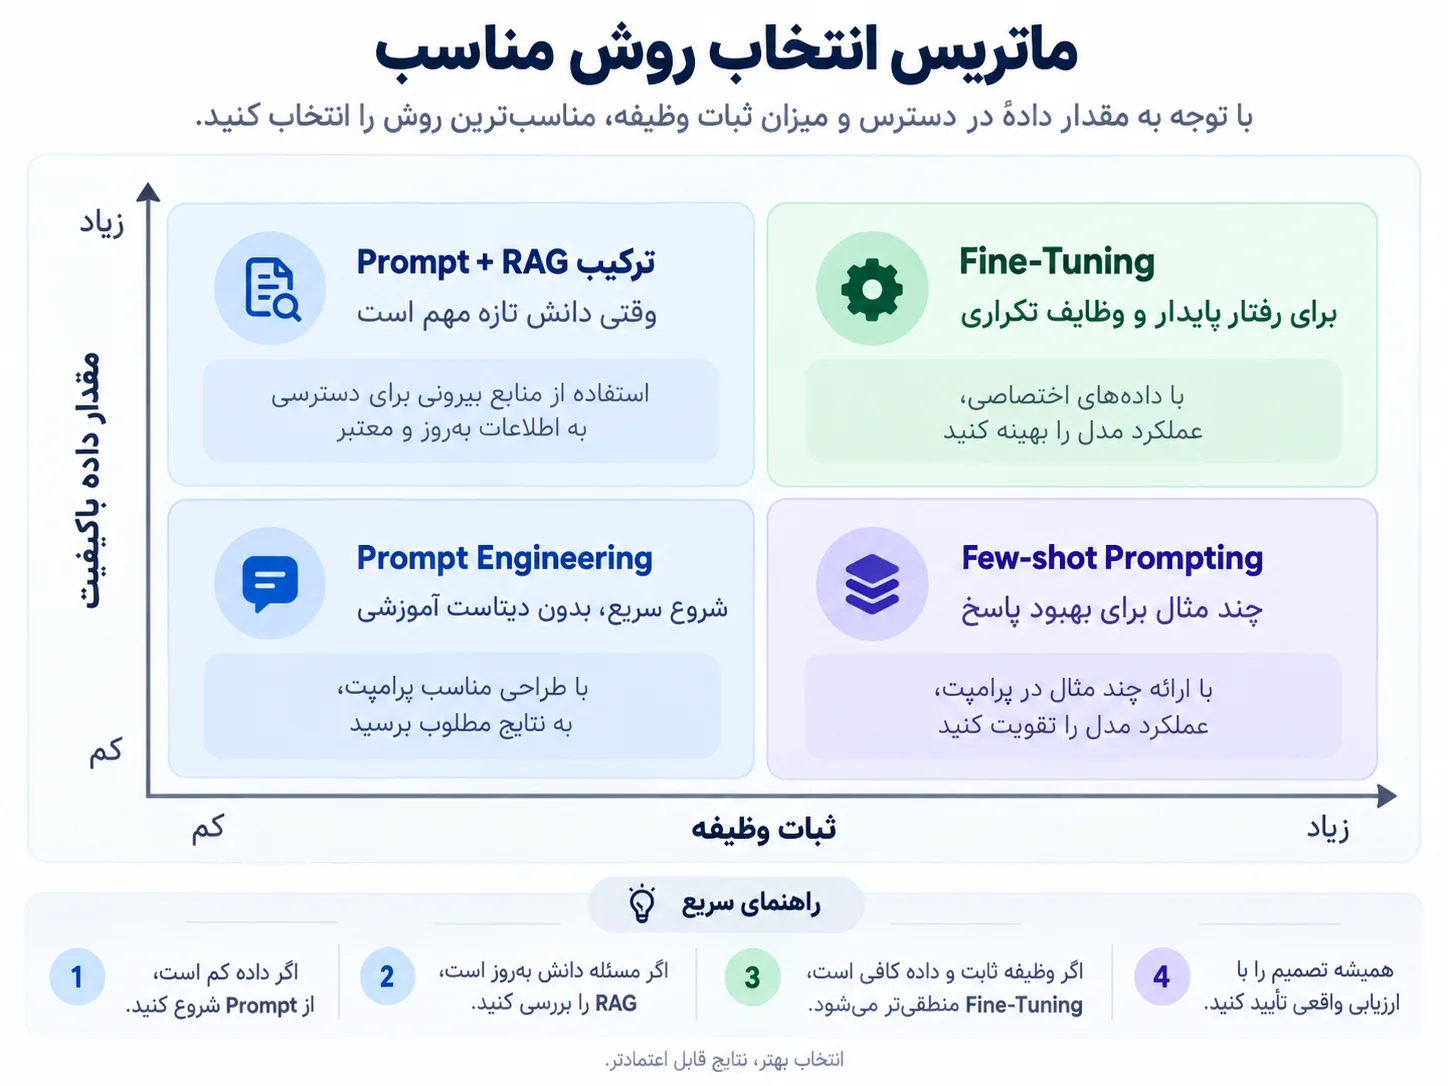
نکته مهم این است که Fine-Tuning را نباید قبل از تعریف معیار موفقیت شروع کرد. ابتدا باید بدانید خروجی خوب دقیقاً چیست و آن را روی یک eval set که از داده آموزش جداست اندازه بگیرید. در غیر این صورت ممکن است مدل فقط نمونههای آموزشی را بهتر تقلید کند و در ورودیهای واقعی بهبود معناداری نداشته باشد.
مثال عملی: دستیار پشتیبانی مشتری
فرض کنید یک دستیار هوش مصنوعی برای پشتیبانی ساختهایم. در نسخه اول، سیستم باید پاسخ مودبانه بدهد، اطلاعات حساس را حدس نزند و خروجی را با ساختار مشخص تولید کند. بهترین نقطه شروع معمولاً یک system prompt دقیق، چند نمونه خوب و ابزارهای لازم برای دسترسی به اطلاعات واقعی مشتری است.
بعد از مدتی متوجه میشویم مدل در لحن برند ناسازگار است، بعضی دستههای درخواست را اشتباه تشخیص میدهد و برای رسیدن به خروجی مناسب باید تعداد زیادی مثال در هر درخواست ارسال کنیم. اگر مجموعه بزرگی از مکالمات تأییدشده و پاکسازیشده داشته باشیم، Fine-Tuning میتواند برای یادگیری این الگوهای تکرارشونده مفید باشد.
اما اگر مشکل اصلی این است که مدل قیمت امروز، وضعیت سفارش، قوانین جدید یا محتوای پایگاه دانش شرکت را نمیداند، Fine-Tuning لزوماً پاسخ اصلی نیست. این اطلاعات تغییر میکنند. در چنین حالتی معمولاً باید داده معتبر را در زمان درخواست از طریق ابزار، جستوجو یا RAG به مدل برسانیم.
Fine-Tuning برای دانش جدید یا RAG؟
این یکی از مهمترین مرزهای تصمیمگیری است. Fine-Tuning بیشتر برای تغییر یا تقویت «رفتار» و عملکرد مدل روی یک وظیفه مناسب است؛ RAG برای واردکردن «اطلاعات مرتبط و قابلبهروزرسانی» در زمان پاسخگویی طراحی میشود.
مثلاً اگر میخواهید دستیار همیشه پاسخ را در فرمت داخلی شرکت بنویسد، Fine-Tuning میتواند مناسب باشد. اگر میخواهید همان دستیار آخرین نسخه قراردادها، محصولات یا مستندات داخلی را بداند، RAG یا ابزار بازیابی معمولاً انتخاب مستقیمتری است. در یک سیستم واقعی، این دو میتوانند همزمان استفاده شوند: Fine-Tuning برای رفتار و RAG برای دانش جاری.
هزینه: کدام روش ارزانتر است؟
Prompt Engineering تقریباً همیشه هزینه شروع پایینتری دارد، چون فرایند آموزش جداگانهای نیاز ندارد. با این حال اگر پرامپت شما به دهها مثال و context ثابت وابسته شود، تعداد توکنهای ورودی و زمان پردازش در هر درخواست افزایش پیدا میکند.
Fine-Tuning هزینه اولیه بیشتری دارد: جمعآوری و پاکسازی داده، برچسبگذاری، آموزش، ارزیابی و نگهداری نسخهها. در عوض، در بعضی کاربردهای پرترافیک ممکن است بتوان پرامپت کوتاهتری استفاده کرد یا مدل کوچکتر و تخصصیتری را به کار گرفت. بنابراین «ارزانتر بودن» باید با هزینه کل سیستم در حجم واقعی درخواستها محاسبه شود، نه فقط هزینه یک مرحله.
کیفیت داده در Fine-Tuning مهمتر از تعداد خام نمونههاست
یکی از اشتباههای رایج این است که تصور کنیم هرچه دیتاست بزرگتر باشد نتیجه بهتر است. اگر مثالها متناقض، اشتباه، تکراری یا خارج از توزیع واقعی محصول باشند، مدل همان الگوهای ضعیف را یاد میگیرد. دیتاست باید رفتار مطلوب را نشان دهد و تا حد ممکن شبیه ورودیهایی باشد که مدل در production خواهد دید.
برای ارزیابی هم نباید همان مثالهای آموزشی را دوباره استفاده کرد. بخشی از داده باید برای validation و evaluation کنار گذاشته شود تا بفهمیم مدل روی نمونههای ندیده چه عملکردی دارد.
LoRA و PEFT چه چیزی را تغییر دادهاند؟
Fine-Tuning الزاماً به معنی بهروزرسانی همه پارامترهای یک مدل بزرگ نیست. روشهای PEFT تلاش میکنند با آموزش تعداد بسیار کمتری پارامتر، مدل را برای وظیفه هدف سازگار کنند. LoRA یا Low-Rank Adaptation یکی از شناختهشدهترین روشهای این خانواده است.
در LoRA وزنهای اصلی مدل معمولاً ثابت میمانند و ماتریسهای کوچکتری برای یادگیری تغییرات موردنیاز آموزش داده میشوند. این رویکرد میتواند مصرف حافظه و هزینه آموزش را نسبت به Full Fine-Tuning کاهش دهد و نگهداری چند آداپتر تخصصی برای یک مدل پایه را سادهتر کند.
آیا Prompt Engineering و Fine-Tuning را میتوان با هم استفاده کرد؟
بله، و در بسیاری از سیستمهای production همین ترکیب منطقیتر است. Fine-Tuning تمام نیاز به prompt را حذف نمیکند. حتی یک مدل تنظیمشده همچنان باید بداند در این درخواست خاص چه کاری انجام دهد، چه contextی معتبر است و خروجی باید برای این کاربر چگونه تولید شود.
یک معماری عملی میتواند اینگونه باشد: مدل پایه مناسب را انتخاب کنید، با Prompt Engineering یک baseline بسازید، خطاها را دستهبندی کنید، برای اطلاعات پویا از RAG یا ابزار استفاده کنید، و فقط اگر الگوهای خطای رفتاری تکرارشونده باقی ماند و داده کافی داشتید، Fine-Tuning را آزمایش کنید. سپس مدل تنظیمشده را دوباره با یک prompt کوتاه و دقیق هدایت کنید.
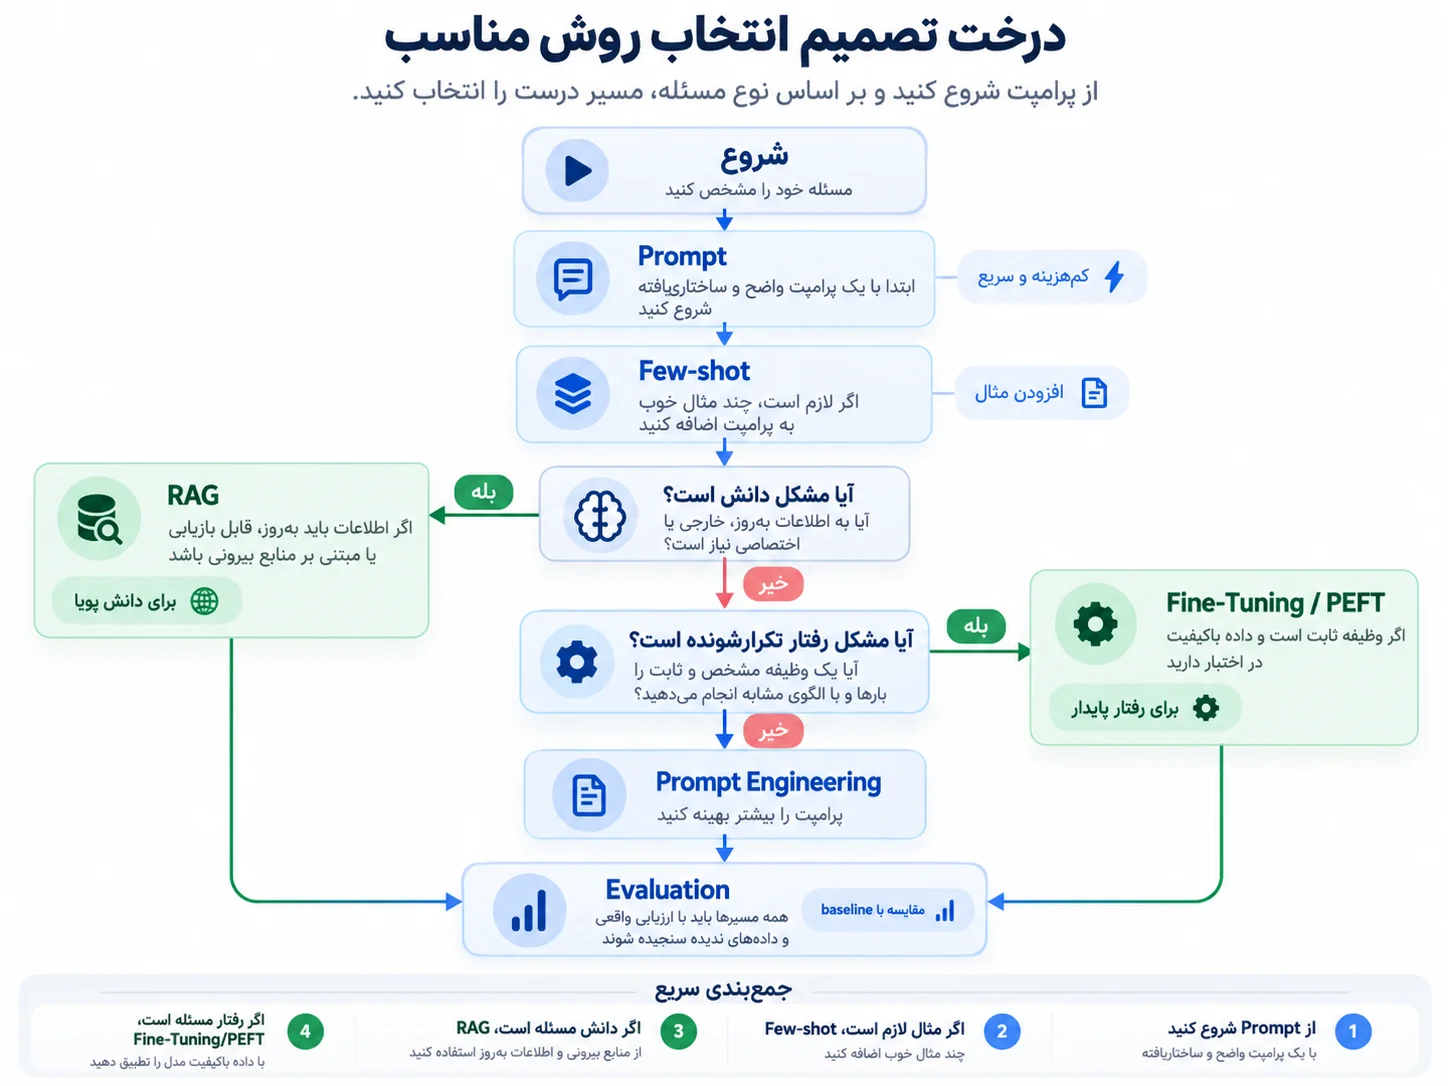
درخت تصمیم: Prompt Engineering یا Fine-Tuning؟
مرحله ۱: آیا با دستور روشن و یک مدل مناسب به نتیجه مطلوب میرسید؟ اگر بله، Prompt Engineering احتمالاً کافی است.
مرحله ۲: اگر نه، آیا چند مثال باکیفیت در پرامپت مشکل را حل میکند؟ اگر بله، few-shot prompting را بسنجید و هزینه توکن را اندازه بگیرید.
مرحله ۳: اگر مشکل اصلی کمبود دانش تازه یا خصوصی است، بهجای Fine-Tuning ابتدا RAG یا tool use را بررسی کنید.
مرحله ۴: اگر مشکل یک رفتار یا الگوی ثابت است و نمونههای باکیفیت زیادی از خروجی مطلوب دارید، Fine-Tuning یا PEFT ارزش آزمایش دارد.
مرحله ۵: نتیجه را روی eval set ثابت با baseline مقایسه کنید. اگر افزایش کیفیت، ثبات یا صرفه اقتصادی واقعی وجود ندارد، پیچیدگی Fine-Tuning توجیهی ندارد.
اشتباههای رایج هنگام انتخاب بین این دو روش
- شروع Fine-Tuning بدون baseline: اگر ندانید مدل با یک پرامپت خوب چقدر عملکرد دارد، نمیتوانید ارزش آموزش را اندازه بگیرید.
- استفاده از Fine-Tuning برای اطلاعات دائماً متغیر: برای دادههای جاری معمولاً retrieval مناسبتر است.
- آموزش روی داده ضعیف: تعداد زیاد نمونه بد، جای چندصد نمونه دقیق و نماینده را نمیگیرد.
- ارزیابی با داده آموزش: این کار میتواند تصور اشتباهی از کیفیت واقعی مدل ایجاد کند.
- نادیده گرفتن هزینه نگهداری: دیتاست، نسخه مدل، pipeline آموزش و evalها همگی باید در طول عمر محصول نگهداری شوند.
- فرض اینکه Fine-Tuning پرامپت را حذف میکند: مدل تنظیمشده همچنان به دستور و context مناسب نیاز دارد.
Prompt Tuning با Prompt Engineering یکی نیست
اسم این دو ممکن است گیجکننده باشد. Prompt Engineering معمولاً به طراحی دستور و مثال در سطح متن گفته میشود و وزنهای مدل را تغییر نمیدهد. Prompt Tuning یک روش آموزش پارامترمحور است که در آن نمایشهای قابلآموزش مرتبط با prompt بهینه میشوند و از نظر مفهومی به خانواده روشهای parameter-efficient adaptation نزدیکتر است. بنابراین هنگام مقایسه منابع، این دو اصطلاح را معادل هم در نظر نگیرید.
یک چارچوب عملی برای تیمهای محصول
- مسئله را دقیق تعریف کنید: خروجی خوب چه مشخصاتی دارد؟
- Eval set بسازید: نمونههای واقعی شامل حالتهای عادی و edge case را جمع کنید.
- Baseline بگیرید: مدل مناسب + پرامپت ساده و واضح.
- پرامپت را بهینه کنید: ساختار، مثالها و قالب خروجی را تست کنید.
- خطاها را دستهبندی کنید: مشکل دانش است، استدلال است، قالب است یا رفتار تخصصی؟
- ابزار درست را انتخاب کنید: RAG برای دانش، Fine-Tuning برای الگوی رفتاری/وظیفهای، prompt برای هدایت درخواست.
- آزمایش کنترلشده انجام دهید: نسخه جدید را با baseline روی همان eval set مقایسه کنید.
- هزینه production را اندازه بگیرید: توکن، latency، training، زیرساخت و نگهداری.
جمعبندی: از Prompt Engineering شروع کنیم یا Fine-Tuning؟
برای بیشتر پروژهها، نقطه شروع منطقی Prompt Engineering است؛ چون سریع، کمهزینه و قابلتغییر است و کمک میکند قبل از آموزش مدل، مسئله را دقیقتر بفهمید. اگر پس از ساخت baseline و ارزیابی منظم همچنان خطاهای رفتاری تکرارشونده دارید، پرامپت بهشدت طولانی شده یا نیاز به ثبات بالاتری در یک وظیفه مشخص دارید، Fine-Tuning میتواند مرحله بعدی باشد.
در عین حال، اگر مسئله اصلی دسترسی به اطلاعات تازه یا خصوصی است، بهتر است RAG یا ابزار بازیابی را وارد معماری کنید. در عمل بهترین سیستمها الزاماً فقط یکی از این روشها را انتخاب نمیکنند؛ Prompt Engineering، Fine-Tuning و RAG هرکدام مسئله متفاوتی را حل میکنند و زمانی بیشترین ارزش را دارند که براساس داده و ارزیابی واقعی کنار هم قرار بگیرند.
سؤالات متداول
آیا Fine-Tuning همیشه دقت مدل را افزایش میدهد؟
خیر. نتیجه به مدل پایه، کیفیت و پوشش دیتاست، روش آموزش و معیار ارزیابی وابسته است. داده نامناسب حتی میتواند عملکرد مدل را روی بعضی ورودیها بدتر کند.
آیا با Fine-Tuning دیگر نیازی به Prompt Engineering نداریم؟
خیر. Fine-Tuning میتواند بعضی دستورها و الگوهای تکراری را در رفتار مدل تثبیت کند، اما هر درخواست همچنان به هدف، context و محدودیتهای روشن نیاز دارد.
برای Fine-Tuning چند نمونه لازم است؟
عدد ثابت و عمومی وجود ندارد. پیچیدگی وظیفه، تنوع ورودیها، کیفیت نمونهها و مدل پایه تعیینکنندهاند. بهجای دنبالکردن یک عدد جادویی، با دیتاست کوچک اما باکیفیت شروع کنید و منحنی عملکرد را با اضافهشدن داده اندازه بگیرید.
برای اطلاعات اختصاصی شرکت Fine-Tuning بهتر است یا RAG؟
اگر اطلاعات مرتب تغییر میکند یا باید بتوان منبع آن را بهروزرسانی کرد، RAG معمولاً نقطه شروع مناسبتری است. Fine-Tuning بیشتر برای یادگیری رفتار، سبک یا الگوهای یک وظیفه مناسب است. این دو روش قابل ترکیباند.
LoRA همان Fine-Tuning است؟
LoRA یکی از روشهای Parameter-Efficient Fine-Tuning است. بهجای آموزش همه وزنهای مدل، مجموعه کوچکتری از پارامترها برای یادگیری تغییرات موردنیاز آموزش داده میشود.